让小程序里流式 Markdown 渲染更丝滑
在微信小程序 Agent 对话中实现流式 Markdown 渲染:从 SSE 事件恢复和展示调度,到增量解析、节点复用、动画对账与局部 setData。
最近在做一个微信小程序里的 Agent 对话,需要把模型持续返回的内容渲染成 Markdown。这里处理的不是一段已经生成完的文档,而是一份仍在不断增长、语法随时可能不完整的文本。
从模型输出到小程序视图,中间要依次处理几类不同的问题:网络回调只提供没有业务边界的字节片段;SSE 事件需要重新组装;增量文本需要按合适的节奏进入页面;Markdown 解析器要面对未闭合的结构;最终的节点更新还要通过 setData 跨逻辑层和视图层完成。
这几个环节的边界不同,处理方式也不同。本文按照实际的数据流顺序展开:先从字节流中恢复可靠的业务事件,再把不均匀的增量整理成稳定的展示节奏,最后只让仍在变化的 Markdown 结构参与解析和渲染。
1. SSE 事件边界与传输分段
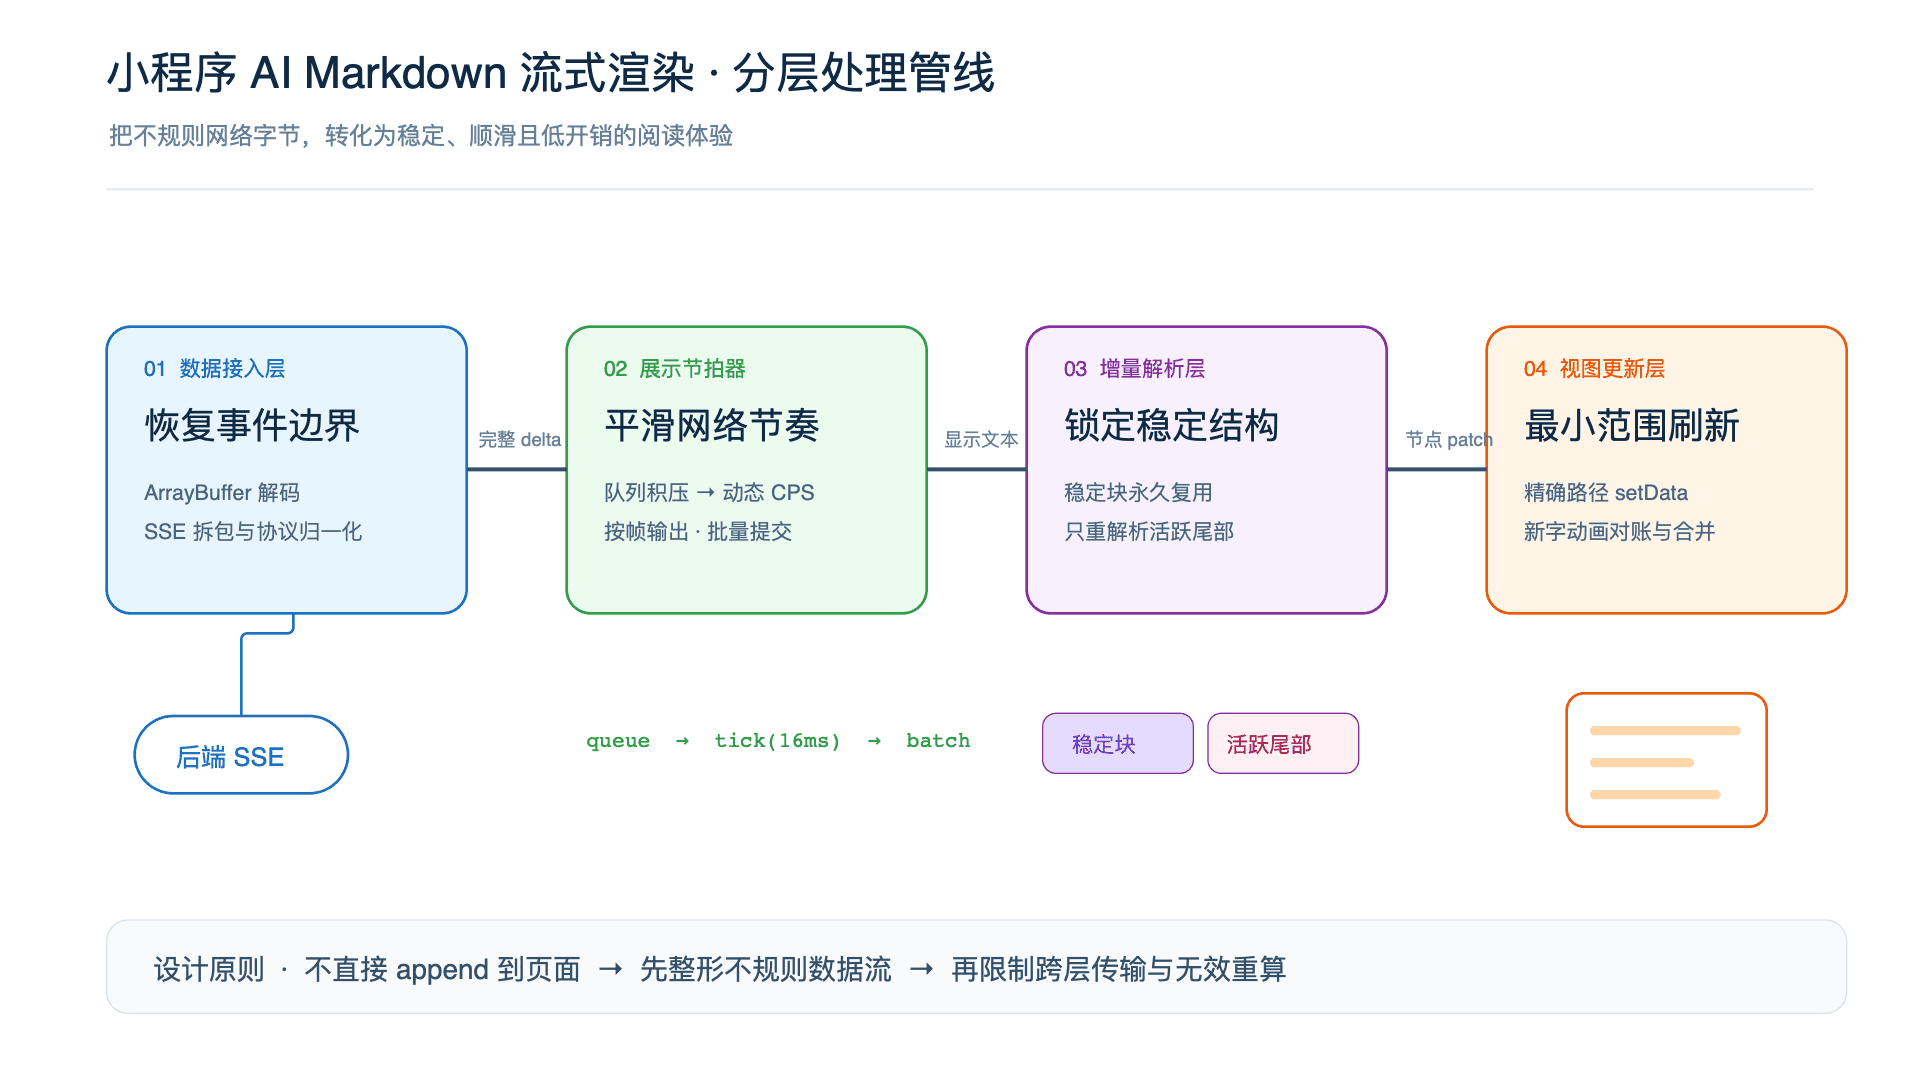
一次 onChunkReceived 回调不能直接当成一条 SSE 消息。SSE 和传输分段不在同一层:SSE 是应用层协议,约定客户端如何从文本流中识别一条事件;传输层只负责持续送达字节,并不承诺与事件对齐。
SSE 通过字段和空行定义事件结构;传输分段则由 HTTP 协议和网络实现决定。两者之间不存在一一对应关系。
SSE 定义的是事件格式,例如:
data: {"answer":{"data":"你好"}}

data: {"answer":{"data":",有什么可以帮你?"}}
在 HTTP/1.1 中,Transfer-Encoding: chunked 是一种典型的响应体分段方式;但 HTTP/2 不使用这一套报文分块格式。对小程序业务代码而言,更稳妥的抽象是“持续到达的网络字节回调”,而不是依赖底层传输帧的形态。无论底层如何分段,一次网络回调都可能只拿到半条 SSE 事件,也可能连着拿到多条。
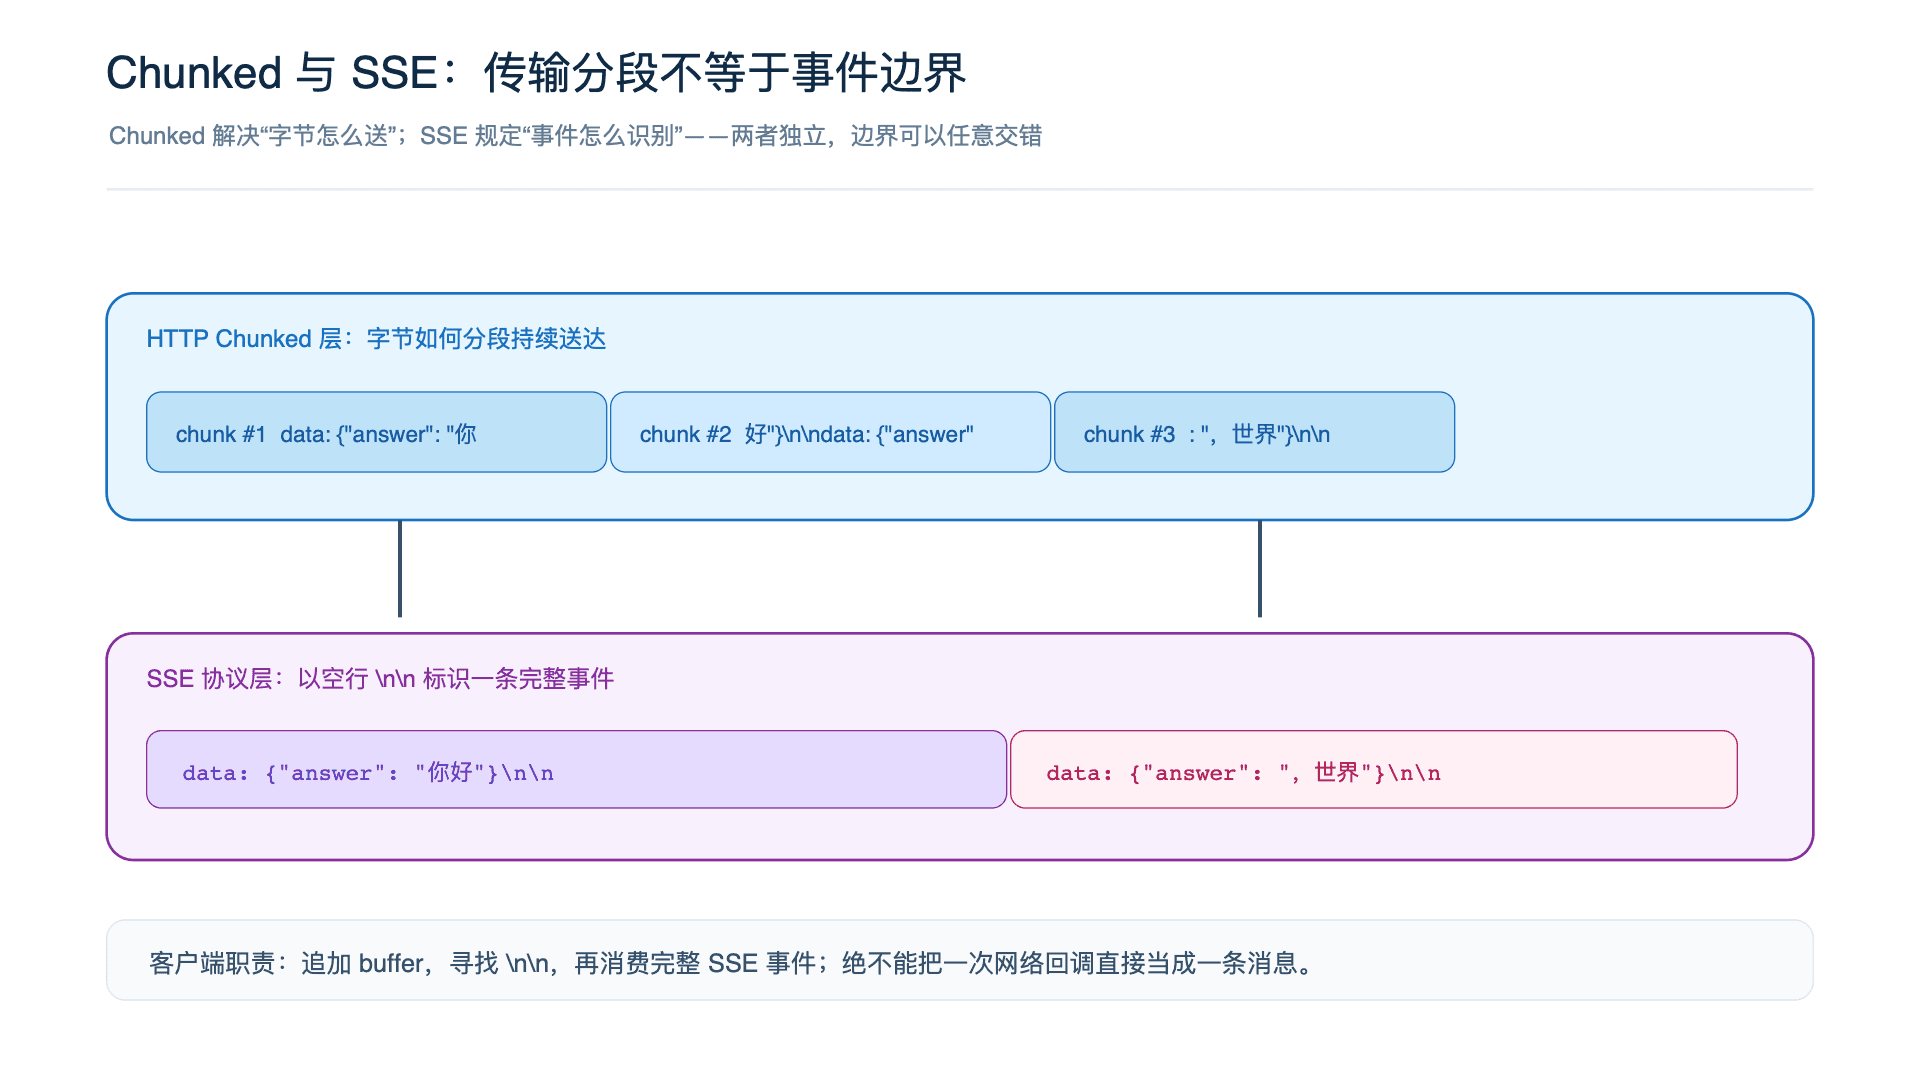
所以客户端不能把一次 onChunkReceived 当成一条消息。它拿到的首先只是字节:
const task = wx.request({
  url: '/api/ask',
  method: 'POST',
  enableChunked: true,
  timeout: 60_000,
});

task.onChunkReceived((res) => {
  // res.data 是 ArrayBuffer,不是 JSON
});
解码后的内容也还不能立即当作一条 SSE 消息处理。SSE parser 需要保存未完成事件:每次把字符流追加到 buffer,只在找到空行分隔符后消费完整事件:
buffer += chunk;

let index = buffer.indexOf('\n\n');
while (index !== -1) {
  const rawEvent = buffer.slice(0, index);
  buffer = buffer.slice(index + 2);
  consumeRawEvent(rawEvent);
  index = buffer.indexOf('\n\n');
}
这段代码只展示事件边界恢复的主干。完整实现还需要兼容 \r\n 换行、连续多行 data:、注释心跳,以及业务自己的结束或错误事件;这些细节应集中在 SSE parser 内部,不向后续渲染链路泄漏。
这样,无论一条事件被拆成几次回调,还是多条事件粘在同一次回调里,向上交付的都是完整业务事件。数据接入层只负责恢复事件边界;至于内容应以怎样的节奏出现,交给下一层处理。
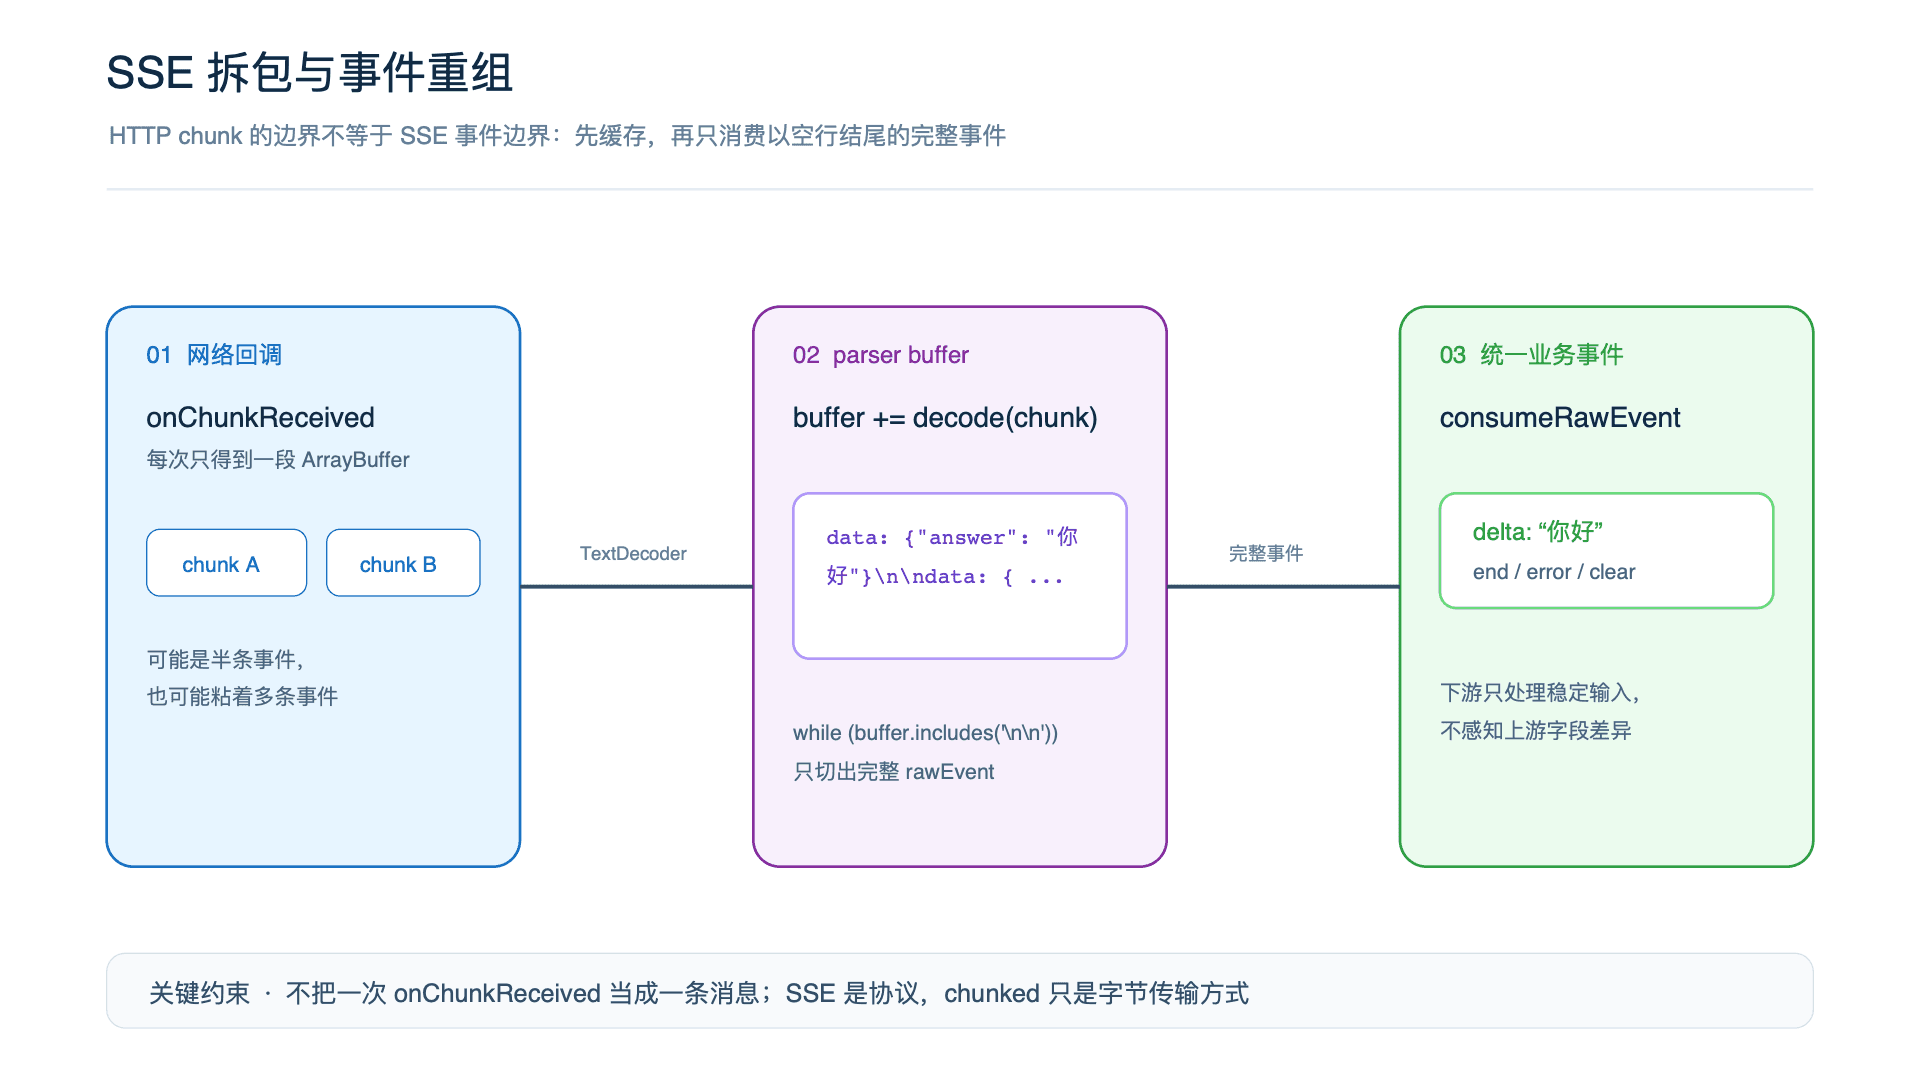
数据接入层还应完成协议归一化,将不同事件字段转换为统一的增量文本和少量控制信号。这样节拍器只接触一种稳定输入,结束、清空和异常也不会混入正文拼接逻辑;上游字段变化时,调度与渲染层无需同步调整。
到这里,网络层的问题已经收敛成连续的 delta,但 delta 的到达仍然忽快忽慢。如果收到一段就立即更新一次页面,用户看到的仍然是网络节奏,而不是连续的生成过程。
2. StreamingRenderBuffer:流式文本的节拍调度
如果每收到一个 delta 就立即渲染,页面会继承网络的抖动:有时停顿很久,有时突然跳出一大段。固定为“每 30ms 一个字”也不理想——网络已经先到 200 个字时,展示端还要额外排队数秒。
数据接入层与 Markdown 引擎之间设置一个 StreamingRenderBuffer:push(delta) 接收增量文本,内部队列按帧消费字符,再将同一帧的结果合并后交给渲染层。它负责控制展示速率,并在队列积压时主动追赶已经到达的数据。
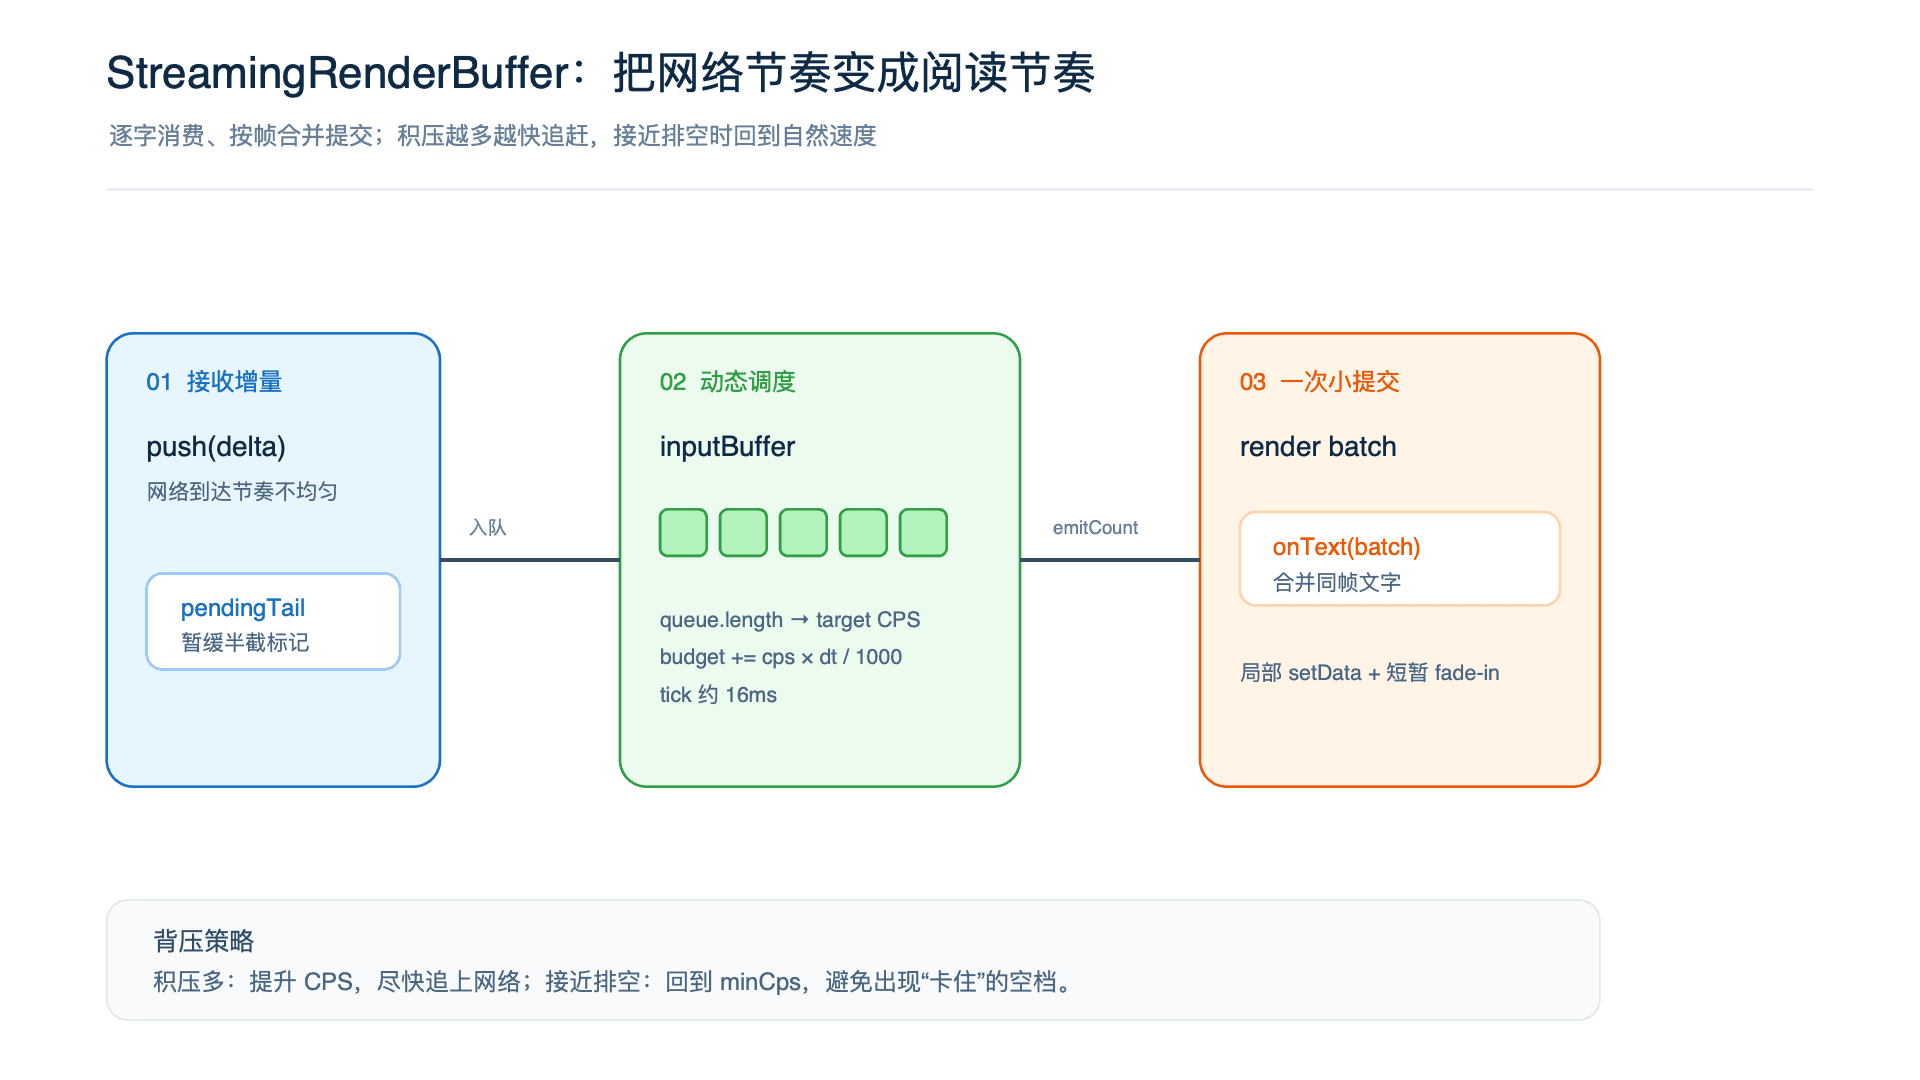
delta → pendingTail → inputBuffer → tick(16ms) → render batch → setData其中 inputBuffer 是待展示的字符队列;pendingTail 用来暂存可能影响 Markdown 解析的尾部字符,例如孤立的 ]、* 或 -。它们先暂缓一个字符,等到下一个字符确认语义后再进入队列;流结束时由 flush() 将暂缓内容一并输出。这是一个很小的保护,但能减少链接、强调和列表标记刚好被截断时的视觉跳变。
buffer 对外只暴露少量生命周期接口:
interface StreamingRenderBuffer {
  push(text: string): void;  // 收到新的 delta
  seal(): void;              // 不再接收新内容,等待自然排空
  flush(): void;             // 立即输出队列和 pendingTail
  stop(): void;              // 内容作废,直接清空
  destroy(): void;           // 页面卸载,取消定时器与引用
}
最直接的背压信号就是队列长度。积压越多,目标字符速率(CPS)越高;接近排空时,速率回落到设定的下限:
function computeTargetCps(): number {
  if (queue.length === 0) return minCps;

  const desired = (queue.length * 1000) / targetLatencyMs;
  return Math.max(minCps, Math.min(maxCps, desired));
}
例如 minCps: 30、maxCps: 200、targetLatencyMs: 100,分别约束最低输出速率、最高追赶速率和目标展示延迟。无需额外估算网络状态,队列积压本身就是直接的背压信号。
跨帧字符预算
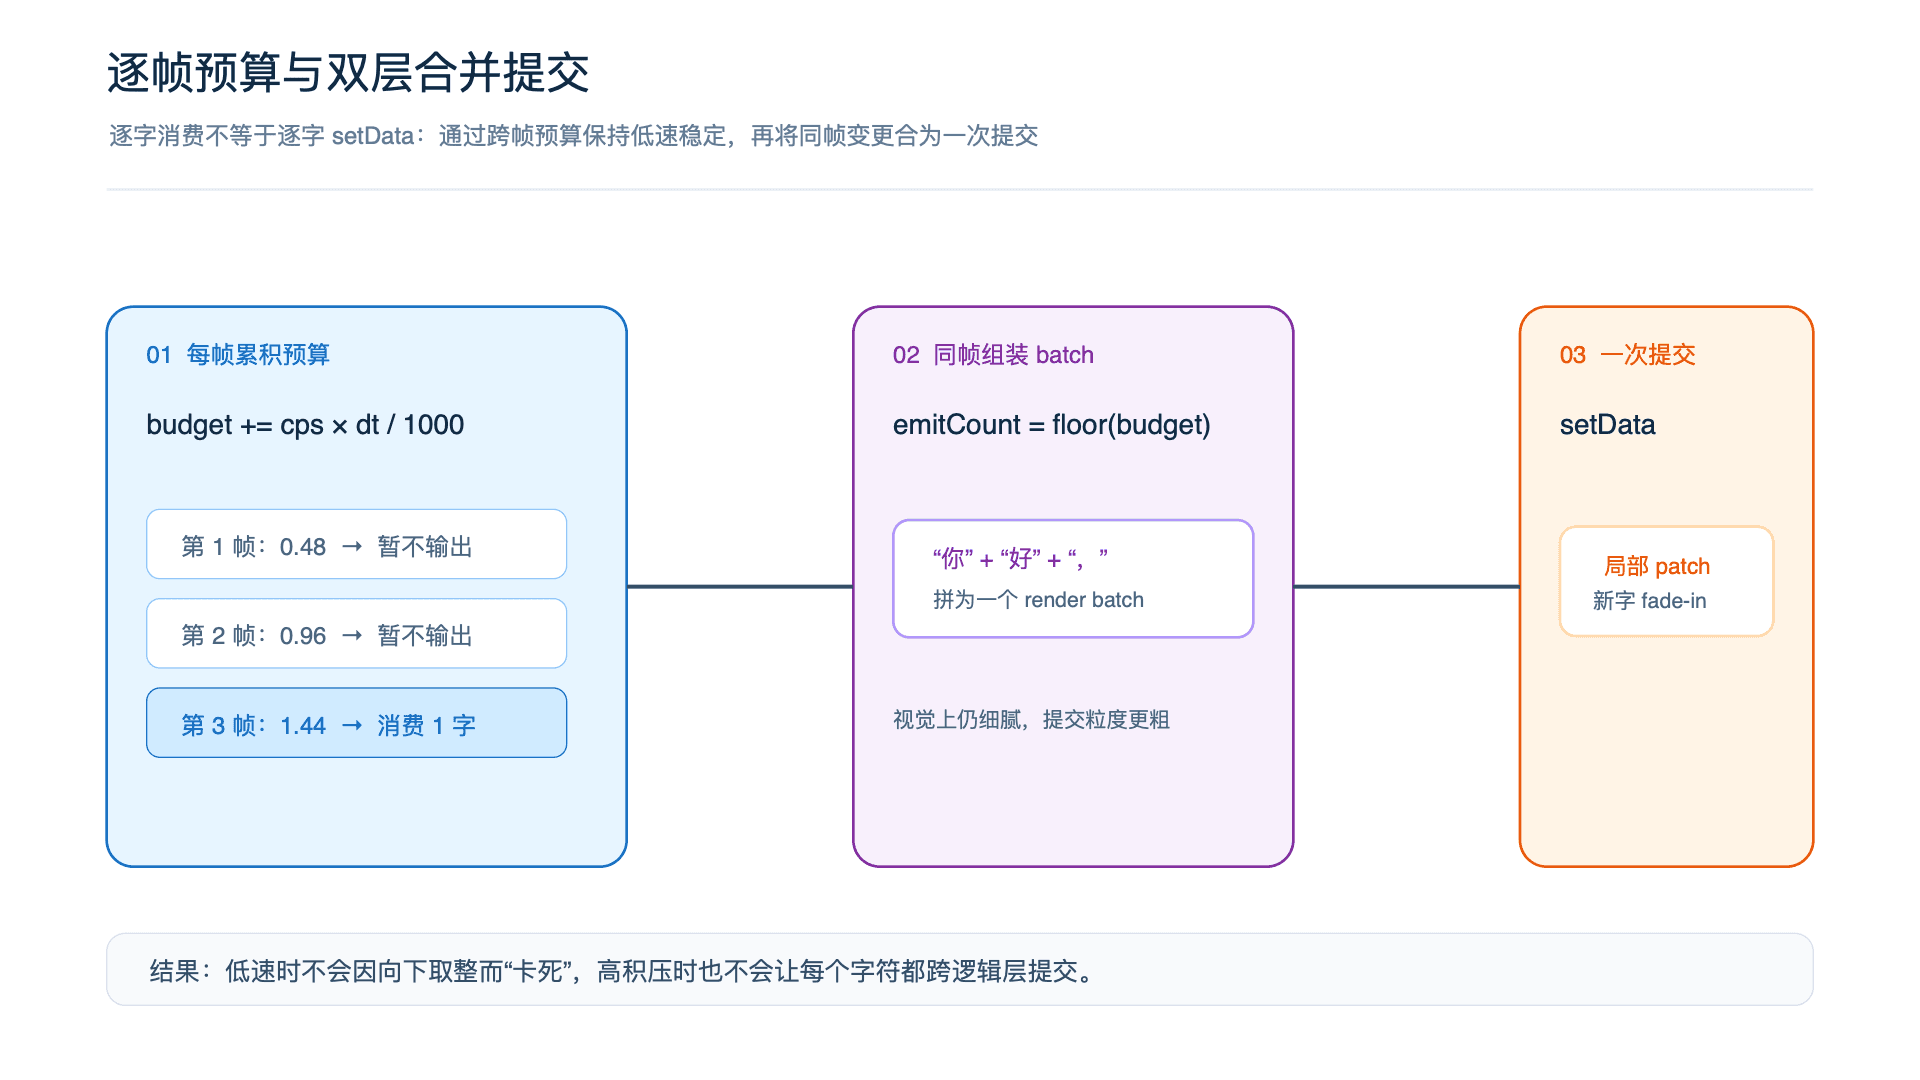
小程序里通常用约 16ms 的 setTimeout 驱动循环。30 CPS 在一帧内不足半个字符,若直接向下取整,低速时会长期不输出;若每帧强制输出一个字符,实际速度又会被抬到 60 CPS 左右。
解决方法是保留跨帧预算:
runtime.budget += (cps * dt) / 1000;

const emitCount = Math.floor(runtime.budget);
runtime.budget -= emitCount;
预算累计到 1 才消费一个字符,小数继续留给下一帧。dt 可以设置上限,例如 100ms,避免应用从后台恢复时把不可见期间积累的时间一次性“补发”到屏幕上。
这里应使用真实经过时间,而不是假定每一帧都正好 16ms。优先使用运行时可用的单调时间源(例如 performance.now());不可用时再回退到 Date.now()。小程序运行时会受到页面切换、主线程繁忙等影响,真实帧间隔并不稳定。按 targetCps * dt / 1000 计算本帧额度,节奏才能在帧率波动时保持一致。
按帧合并 setData
逐字消费不应等同于逐字调用 setData。buffer 内部的 16ms tick 只负责计算本帧需要输出的字符数;渲染层再将同一帧的变化合并为一次 setData。
小程序的 setData 包含序列化、跨线程通信和视图更新;如果 Markdown 组件也跟着重新计算,一个“逐字提交”的打字机很容易变成性能放大器。实际实现中,会把同一帧内消费的字符拼成 batch,只提交一次:
let batch = '';

function flushBatch() {
  if (!batch) return;
  onText(batch);
  batch = '';
}
队列较短时,一个 batch 接近一个字,视觉上仍然是逐字;积压较多时,一帧会输出一小批,展示端也能及时追上。字符消费粒度与视图提交粒度由此分离,既保留连续的输出反馈,也避免高频跨层更新。
连续结构的缓冲策略
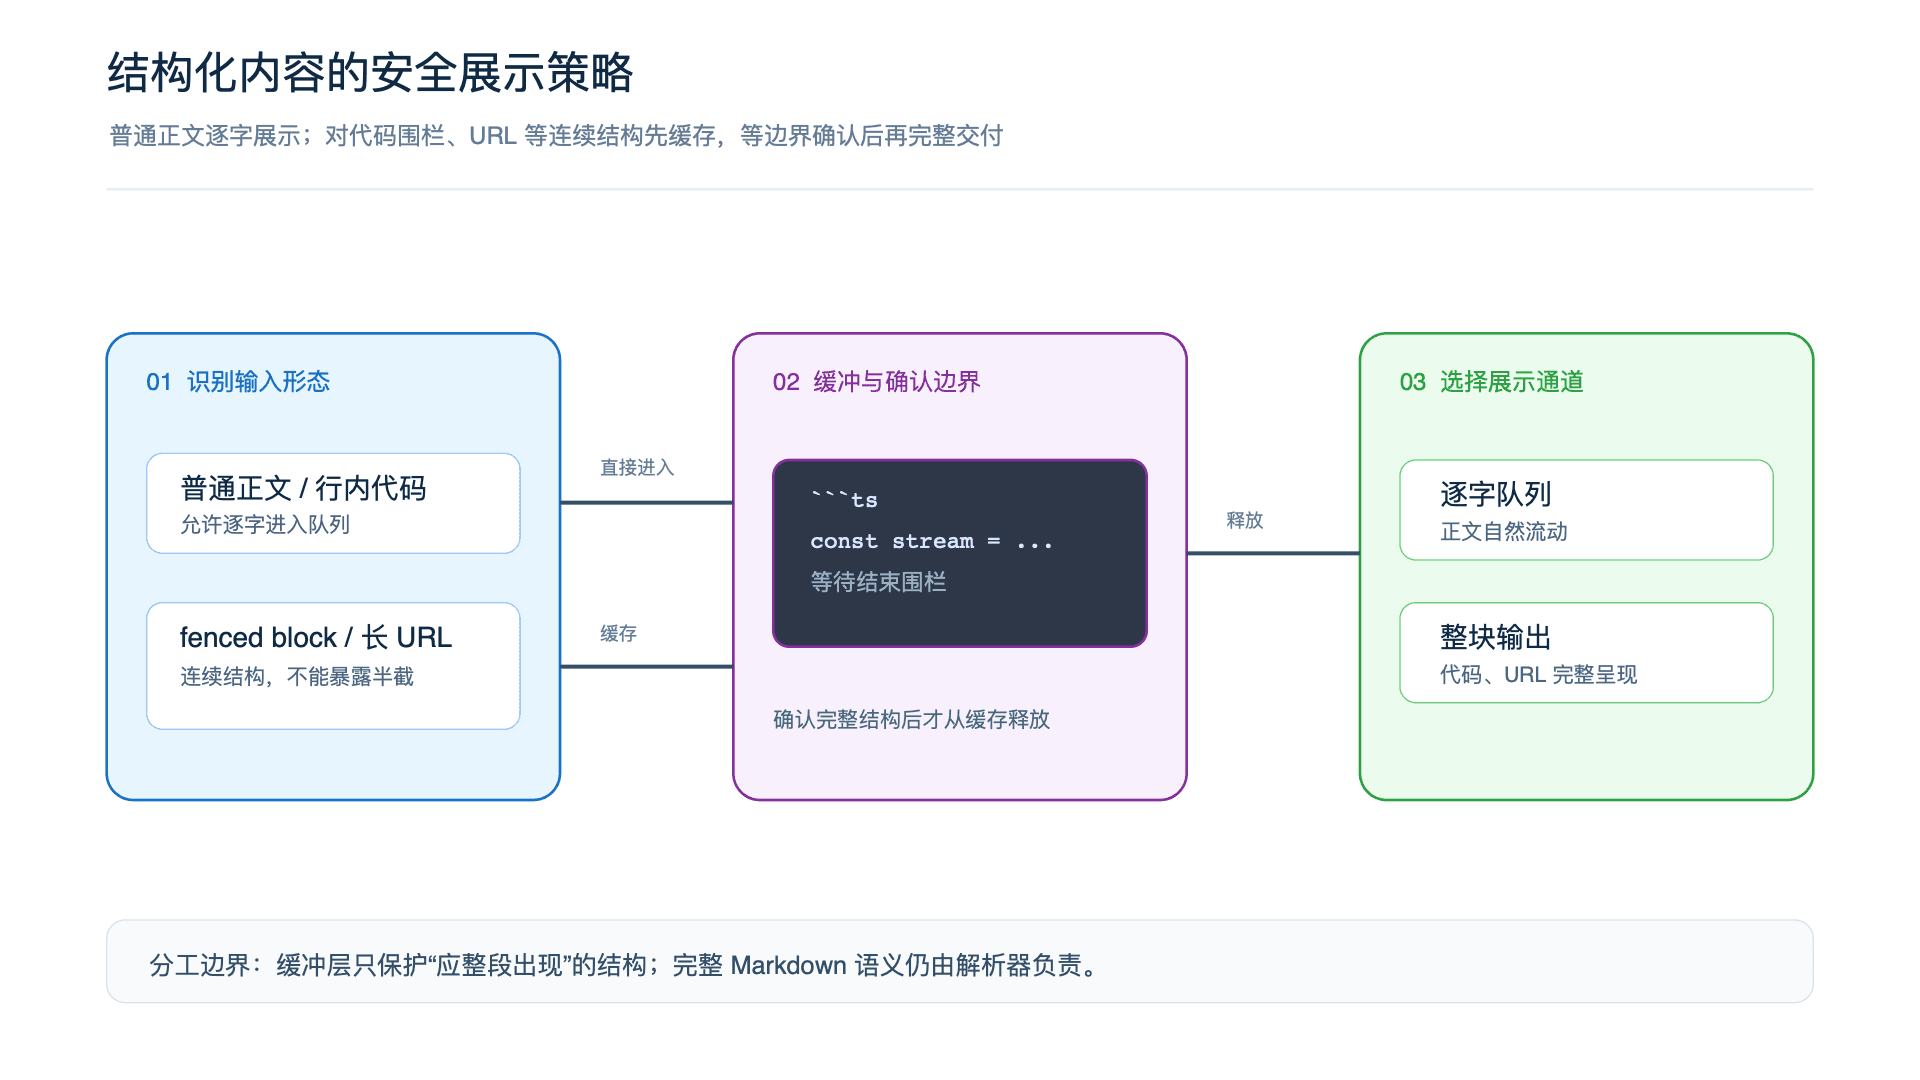
代码围栏不适合直接暴露半截语法。本文采用的默认策略是:识别到起始围栏后先缓存,结束围栏到达后再整块交付。对于较长的代码块,也可以让代码容器先出现,内容按完整行推进,闭合后再做最终高亮。URL、图片链接等连续结构则在识别完整后走快速通道,不进入逐字队列。行内代码仍按普通文本展示。
缓冲层只处理需要连续呈现的结构,以及少量需要暂缓判断的标记;完整的 Markdown 语义仍由解析引擎负责。这样可以避免展示调度与语法解析相互耦合。
生命周期与请求失效
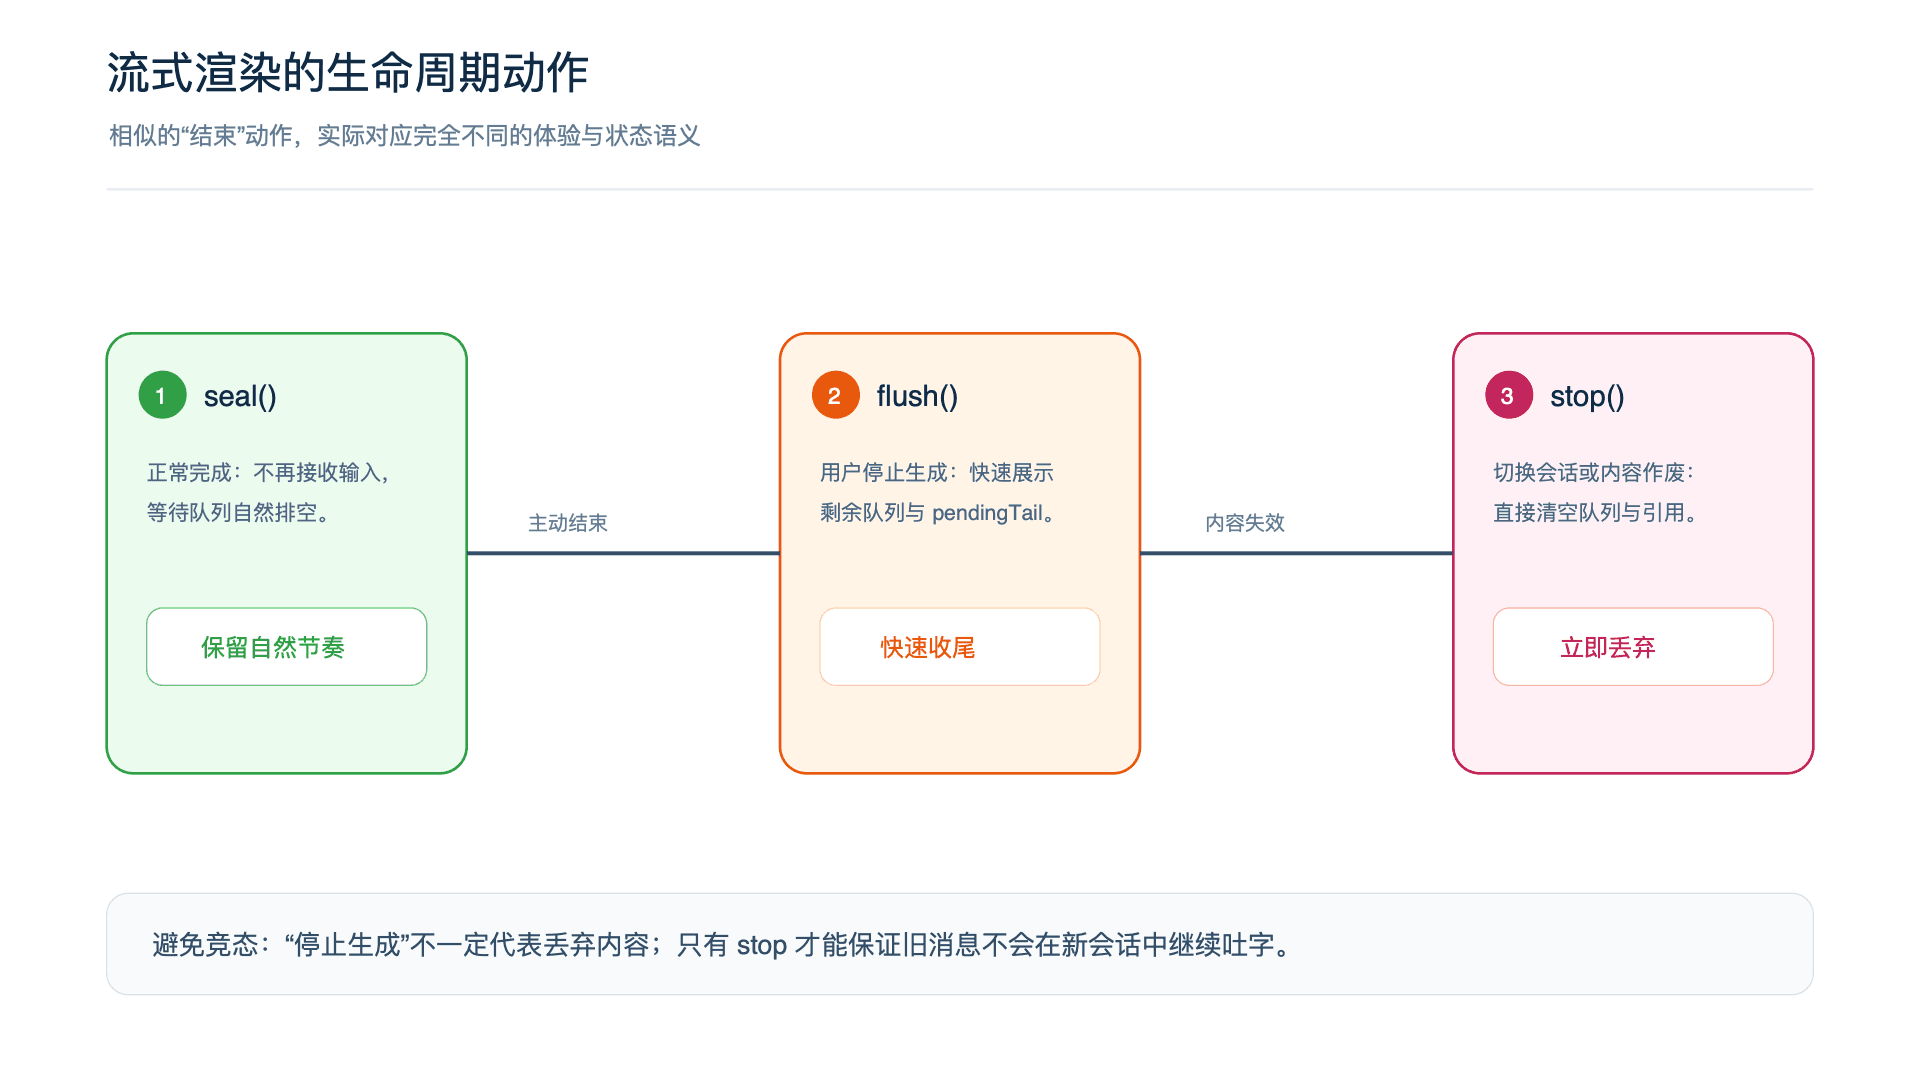
seal() 表示不再接收新内容,但允许队列自然排空;flush() 表示立即展示剩余内容;stop() 则直接丢弃队列。它们分别对应正常结束、用户停止生成和内容已经作废。
如果用户主动停止生成,还需要先取消上游请求,或让当前会话版本失效,再执行 flush()。否则迟到的网络回调仍可能向队列写入内容,使已经停止的消息继续更新。
经过这一层后,网络到达节奏不会再直接传递到页面。faster-markdown 接收到的是按展示进度持续增长的 Markdown 字符串。接下来要解决的问题,已经从“什么时候显示”变成了“不完整的 Markdown 如何稳定地解析和更新”。
3. faster-markdown:面向流式输出的 Markdown 渲染引擎
这里使用的 faster-markdown 不是单独的 parser,而是一套完整的 Markdown 渲染引擎:接收节拍器输出的文本,完成增量解析、节点树生成与复用、局部更新范围计算和动画对账,最终向小程序视图层提供可直接渲染的节点与 patch 信息。
引擎的核心逻辑不依赖具体平台。Vue 和小程序共享同一套解析与增量状态,只在最后一层使用各自的渲染适配器。
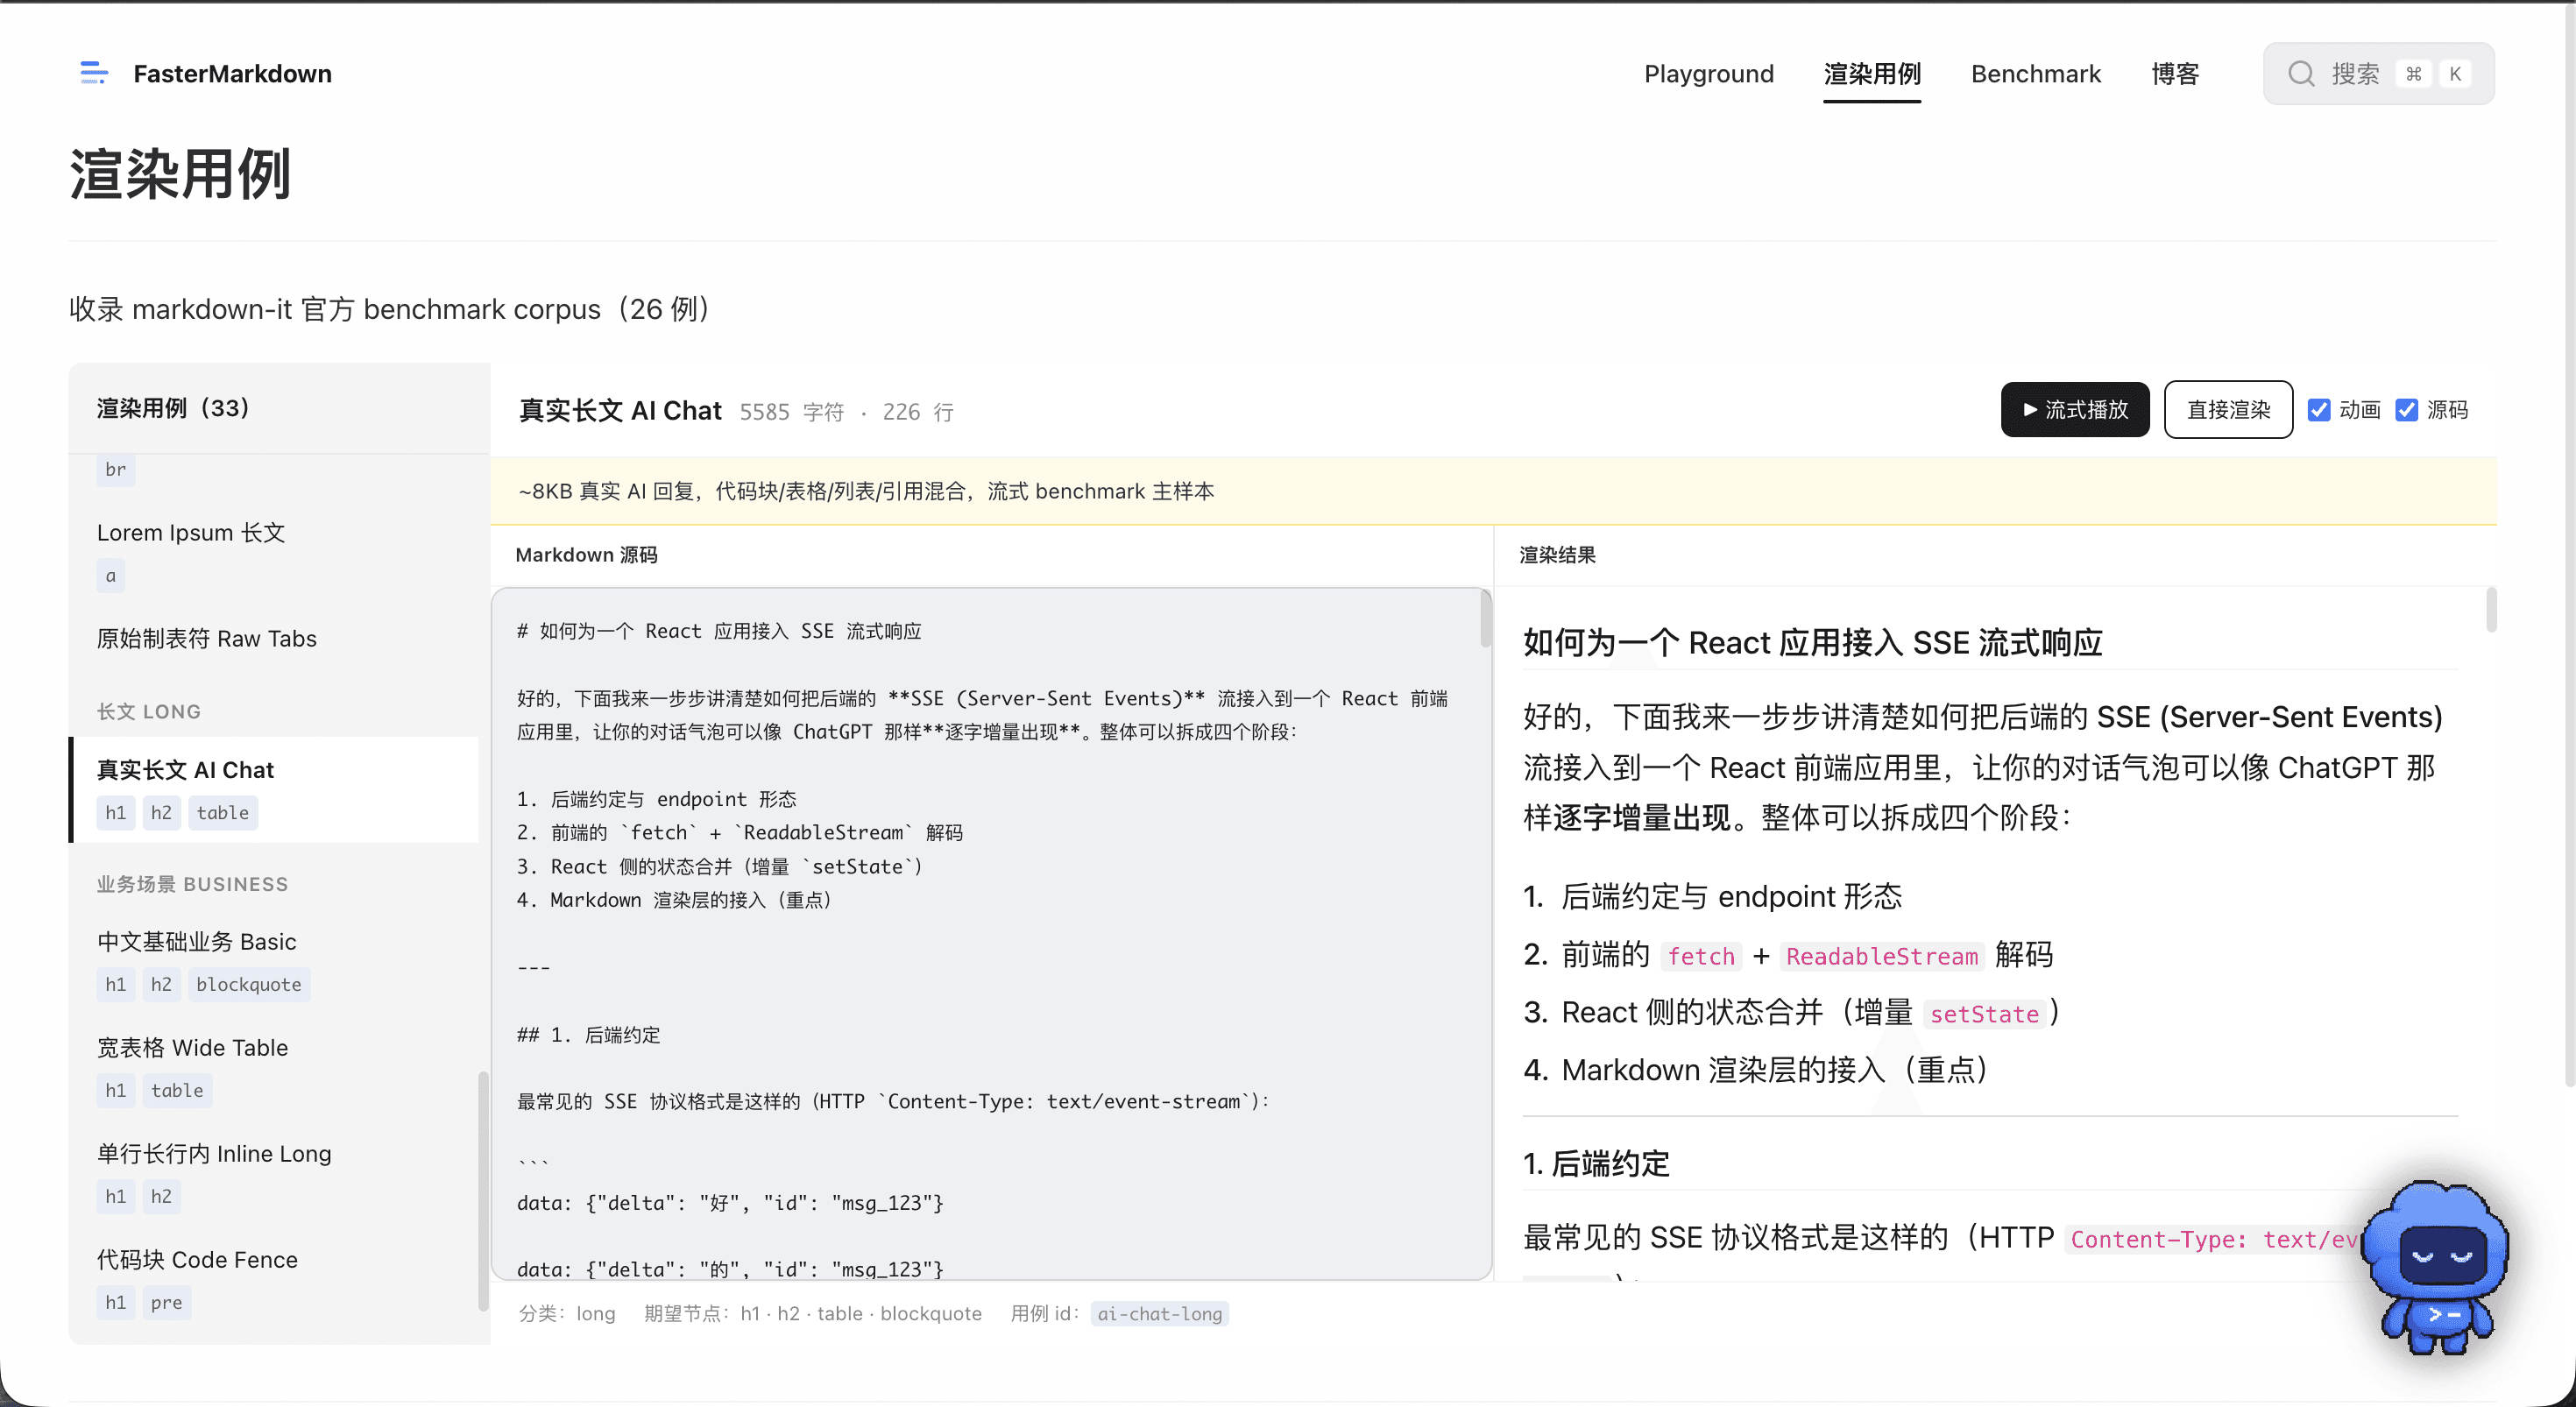
渲染用例覆盖标题、列表、表格、引用、代码围栏和真实长回答,并支持在流式播放与直接渲染之间切换。这些用例既用于检查最终渲染结果,也用于验证增量过程中是否出现结构回跳、动画重播或节点异常重建。
增量解析:稳定块与活跃尾部
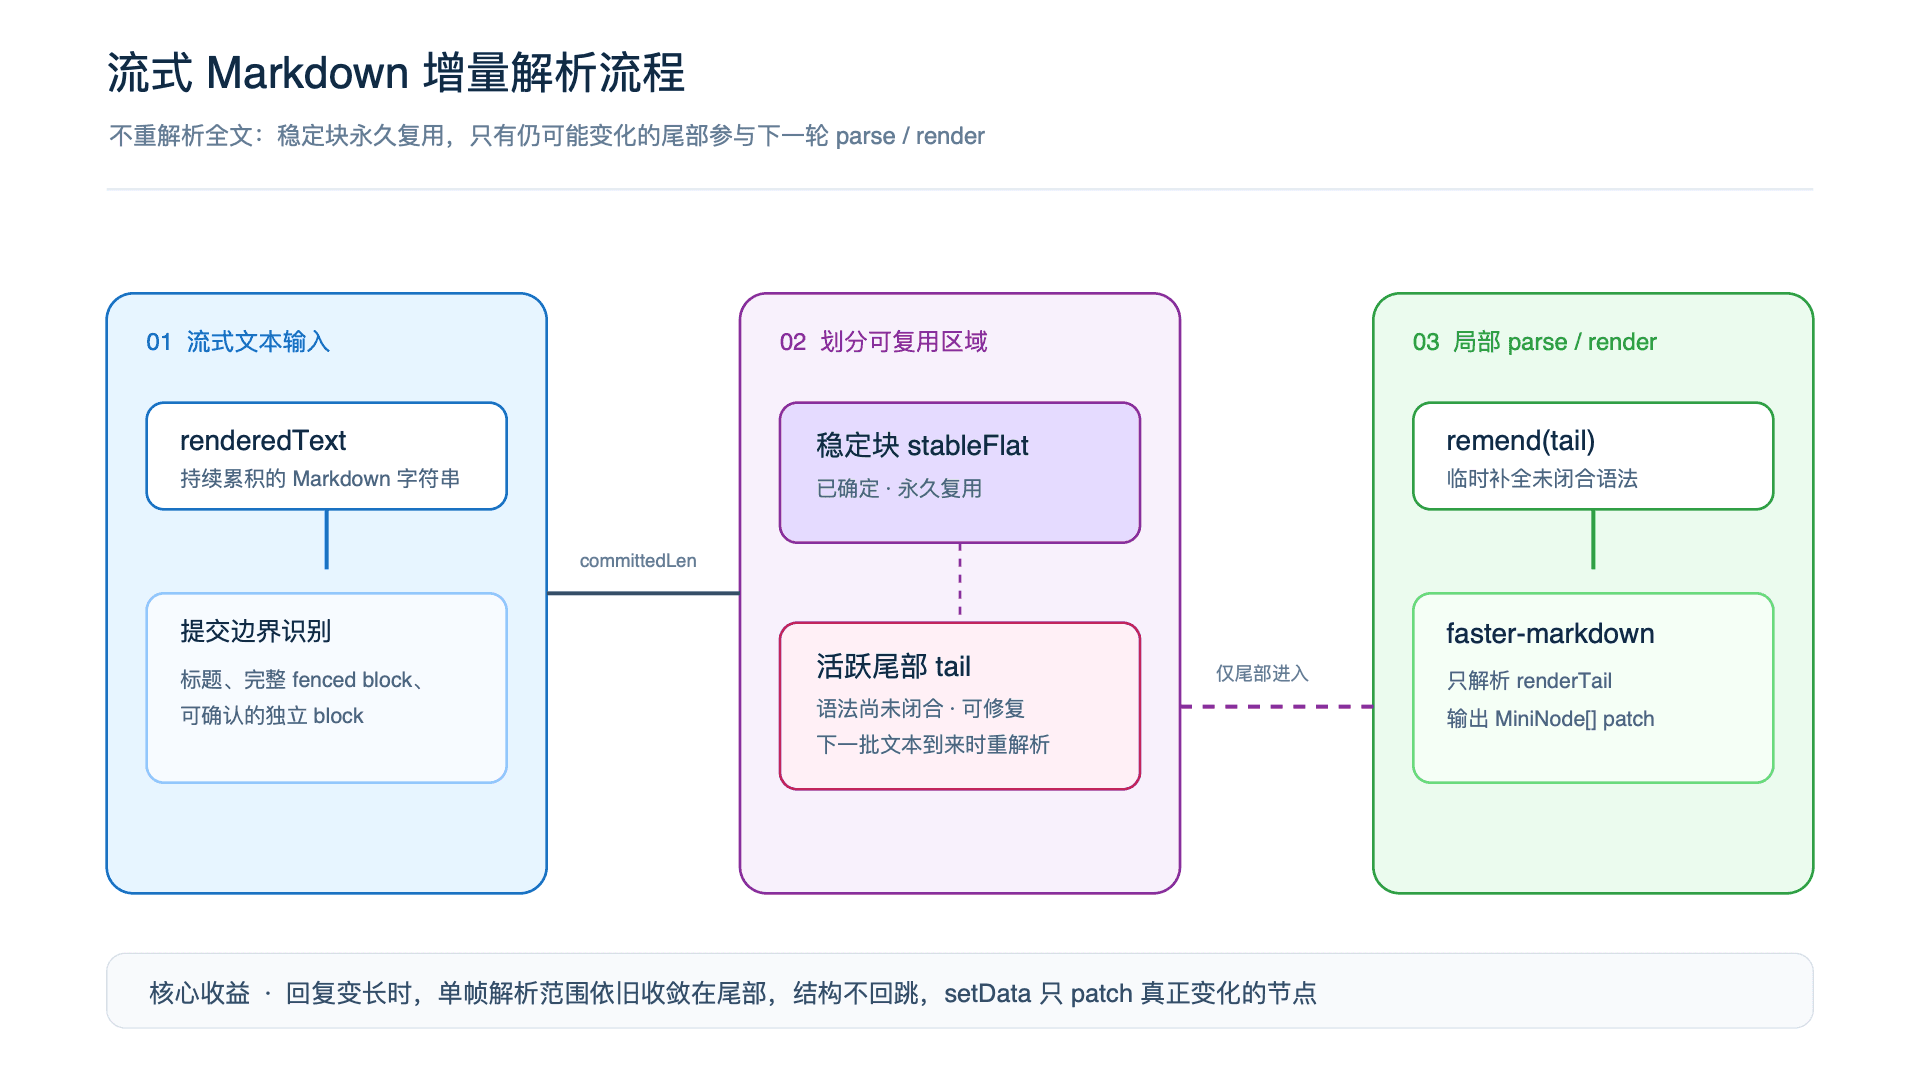
流式 Markdown 的难点不在于“能不能 parse”,而在于文本尾部在大部分时间都不是完整 Markdown:
这是 **还没闭合的强调
[一个还没写完的链接](https://
如果每一帧都把全文重新解析,问题会同时出现:尾部语义在普通文本、强调、链接之间来回跳;答案越长,每帧重复处理的内容越多。
更稳妥的做法,是把全文拆成“稳定块”和“活跃尾部”:
[ 稳定块 ][ 活跃尾部 ]
  已确定      仍可能被后文改变
  永久复用    可以修复、可以重解析
当新的独立 block 到来时,例如标题、分隔线或已闭合的代码围栏,前面的 block 可以提交到稳定区。稳定区扁平化缓存为 stableFlat,后续不再参与解析;每帧只重新处理活跃尾部。随着回复增长,每帧的解析范围不会跟着全文线性增长,而是尽量收敛在最后一小段。
关键在于:提交边界必须保守。不能简单地“遇到空行就提交”,因为列表续行、引用续行、表格和 Setext 标题都可能让后来的行反过来改变前面的结构。一个实用原则是:宁可让尾部稍长,也不要过早固化可能变化的 block。稳定区的价值来自“不会回退”,这个承诺比多缓存一两行更重要。
比如列表项后面紧跟一行缩进内容时,它仍属于同一个列表;引用中的普通行也可能是引用的 lazy continuation;表格要等分隔行完整出现后才能确认。过早提交会让同一段内容在“多个列表”“普通段落”“一个完整列表”之间来回切换。稳定块提交得慢一点,换来的是用户看到的结构不会回跳。
活跃尾部本身仍可能有半截语法。在 faster-markdown 内部,这部分文本会先通过 remend 生成一个临时渲染副本:
const tail = renderedText.slice(committedLen);
const renderTail = tail && needsRemend(tail)
  ? remend(tail, STREAM_FIX_OPTIONS)
  : tail;
比如模型正在输出 **正在生成,当前帧可以临时补齐成闭合强调;链接、代码围栏等未闭合结构也遵循同样思路。下一帧仍然基于真实文本继续处理,补出的字符绝不写回 content。remend 不负责“猜测最终内容”,它只让当前这一帧具备可稳定渲染的语法形态,避免尾部在纯文本、强调和链接之间来回跳。
表格是一个很典型的特殊场景。完整表格需要表头和分隔行来确认,但一旦这两行到齐,后续数据行其实可以逐行加入:已换行的数据行进入稳定结构,最后一行仍留在活跃尾部。这样用户不必等到整张表生成完才看到内容。
| 名称 | 状态 |
| --- | --- |
| 任务 A | 完成 |     ← 已提交的行
| 任务 B | 生成中        ← 活跃行,可显示 loading 占位
当前行尚未遇到换行时,可以渲染一行轻量的 loading 占位;下一行到来后再将它结算为真实表格行。它并不复杂,本质上就是对换行边界的利用,但对长表格的流式观感提升很明显。
节点树、身份与快路径
mp-html 的能力很完整,也很适合“拿到一整段 Markdown 后一次性展示”的场景;但它在流式链路里承担了不必要的中转:逻辑层先把 Markdown 编译成 HTML 字符串,组件侧再把 HTML 解析成自己的节点树,最后才渲染。
流式输出里,一次普通文本追加往往只改变最后一个文本叶子;在旧链路中,它却会被放大成“重新生成 HTML 字符串 → 再解析 HTML → 替换一段节点树”。回答越长、帧数越多,这种重复工作越明显。更麻烦的是,HTML 是匿名字符串,无法可靠地回答“这一段文字是不是上一帧已经出现过”,动画也就很难只作用于新字。
faster-markdown 不生成 HTML,而是直接产出轻量节点树。Vue 侧可以将它映射为 VNode,小程序侧则由递归组件映射到 WXML,解析结果不需要再经过一次 HTML 反解析。
faster-markdown 从一开始就按 block 和文本叶子组织结果:段落、标题、列表、引用、代码围栏是顶层 block;block 内再由文本、链接、强调等行内节点组成。每个节点都带有稳定的 k 或路径,例如 root/0:p/1:text。
这个身份不是为了调试方便。两条列表项可能恰好都包含“完成”,靠文本内容无法判断它是不是旧节点;而有了路径,渲染器就能精确复用上一帧的文本历史、动画 segment 和视图节点。只要内容仍是前缀延续,原 block 的身份就不变。
行内结构还会在解析后进行一次拍平。Markdown 的 **加粗且 *斜体*** 原本是嵌套树;如果原样交给小程序 <text>,组件递归和动画定位都会变复杂。这里将 strong、em、del 等样式合并到文本 run 的 class,叶子主要保留 text、a 等少数类型。渲染层面对的是一组平坦、可定位的文本 run,而不是一棵层层嵌套的行内树。
稳定块/活跃尾部让解析范围缩小,而 faster-markdown 继续在活跃尾部内分流。它并不执着于每帧都跑完整 parser,而是按从便宜到昂贵的顺序处理:
- 提交稳定块。
advanceCommit逐行扫描,确认前文不再可能被后续内容改变后,将它扁平化缓存到stableFlat;之后不再 parse。 - 纯文本直出。 活跃尾部没有 Markdown 触发字符、也不像列表或分隔线时,直接构造段落与文本节点,跳过完整解析。
- 后缀复用。 若新活跃尾部只是旧尾部的普通文本延续,只 patch 最后一个叶子的
value。只有遇到链接闭合、强调边界、列表或表格等会改变结构的内容,才回退到尾部完整解析。
第三层有一个容易忽略的细节:最后一个叶子如果仍带加粗、斜体、删除线或行内代码样式,不能把新字直接拼进去,否则新增文字会临时继承错误样式。正确的做法是创建一个无样式兄弟叶子,或让这一帧回退给解析器重新判断。
这套策略追求的不是某一次解析的绝对速度,而是让流式回答中占绝大多数的普通追加帧足够轻。真正复杂的帧仍然完整解析,但它们出现得少,成本也被限制在活跃尾部,而不是全文。
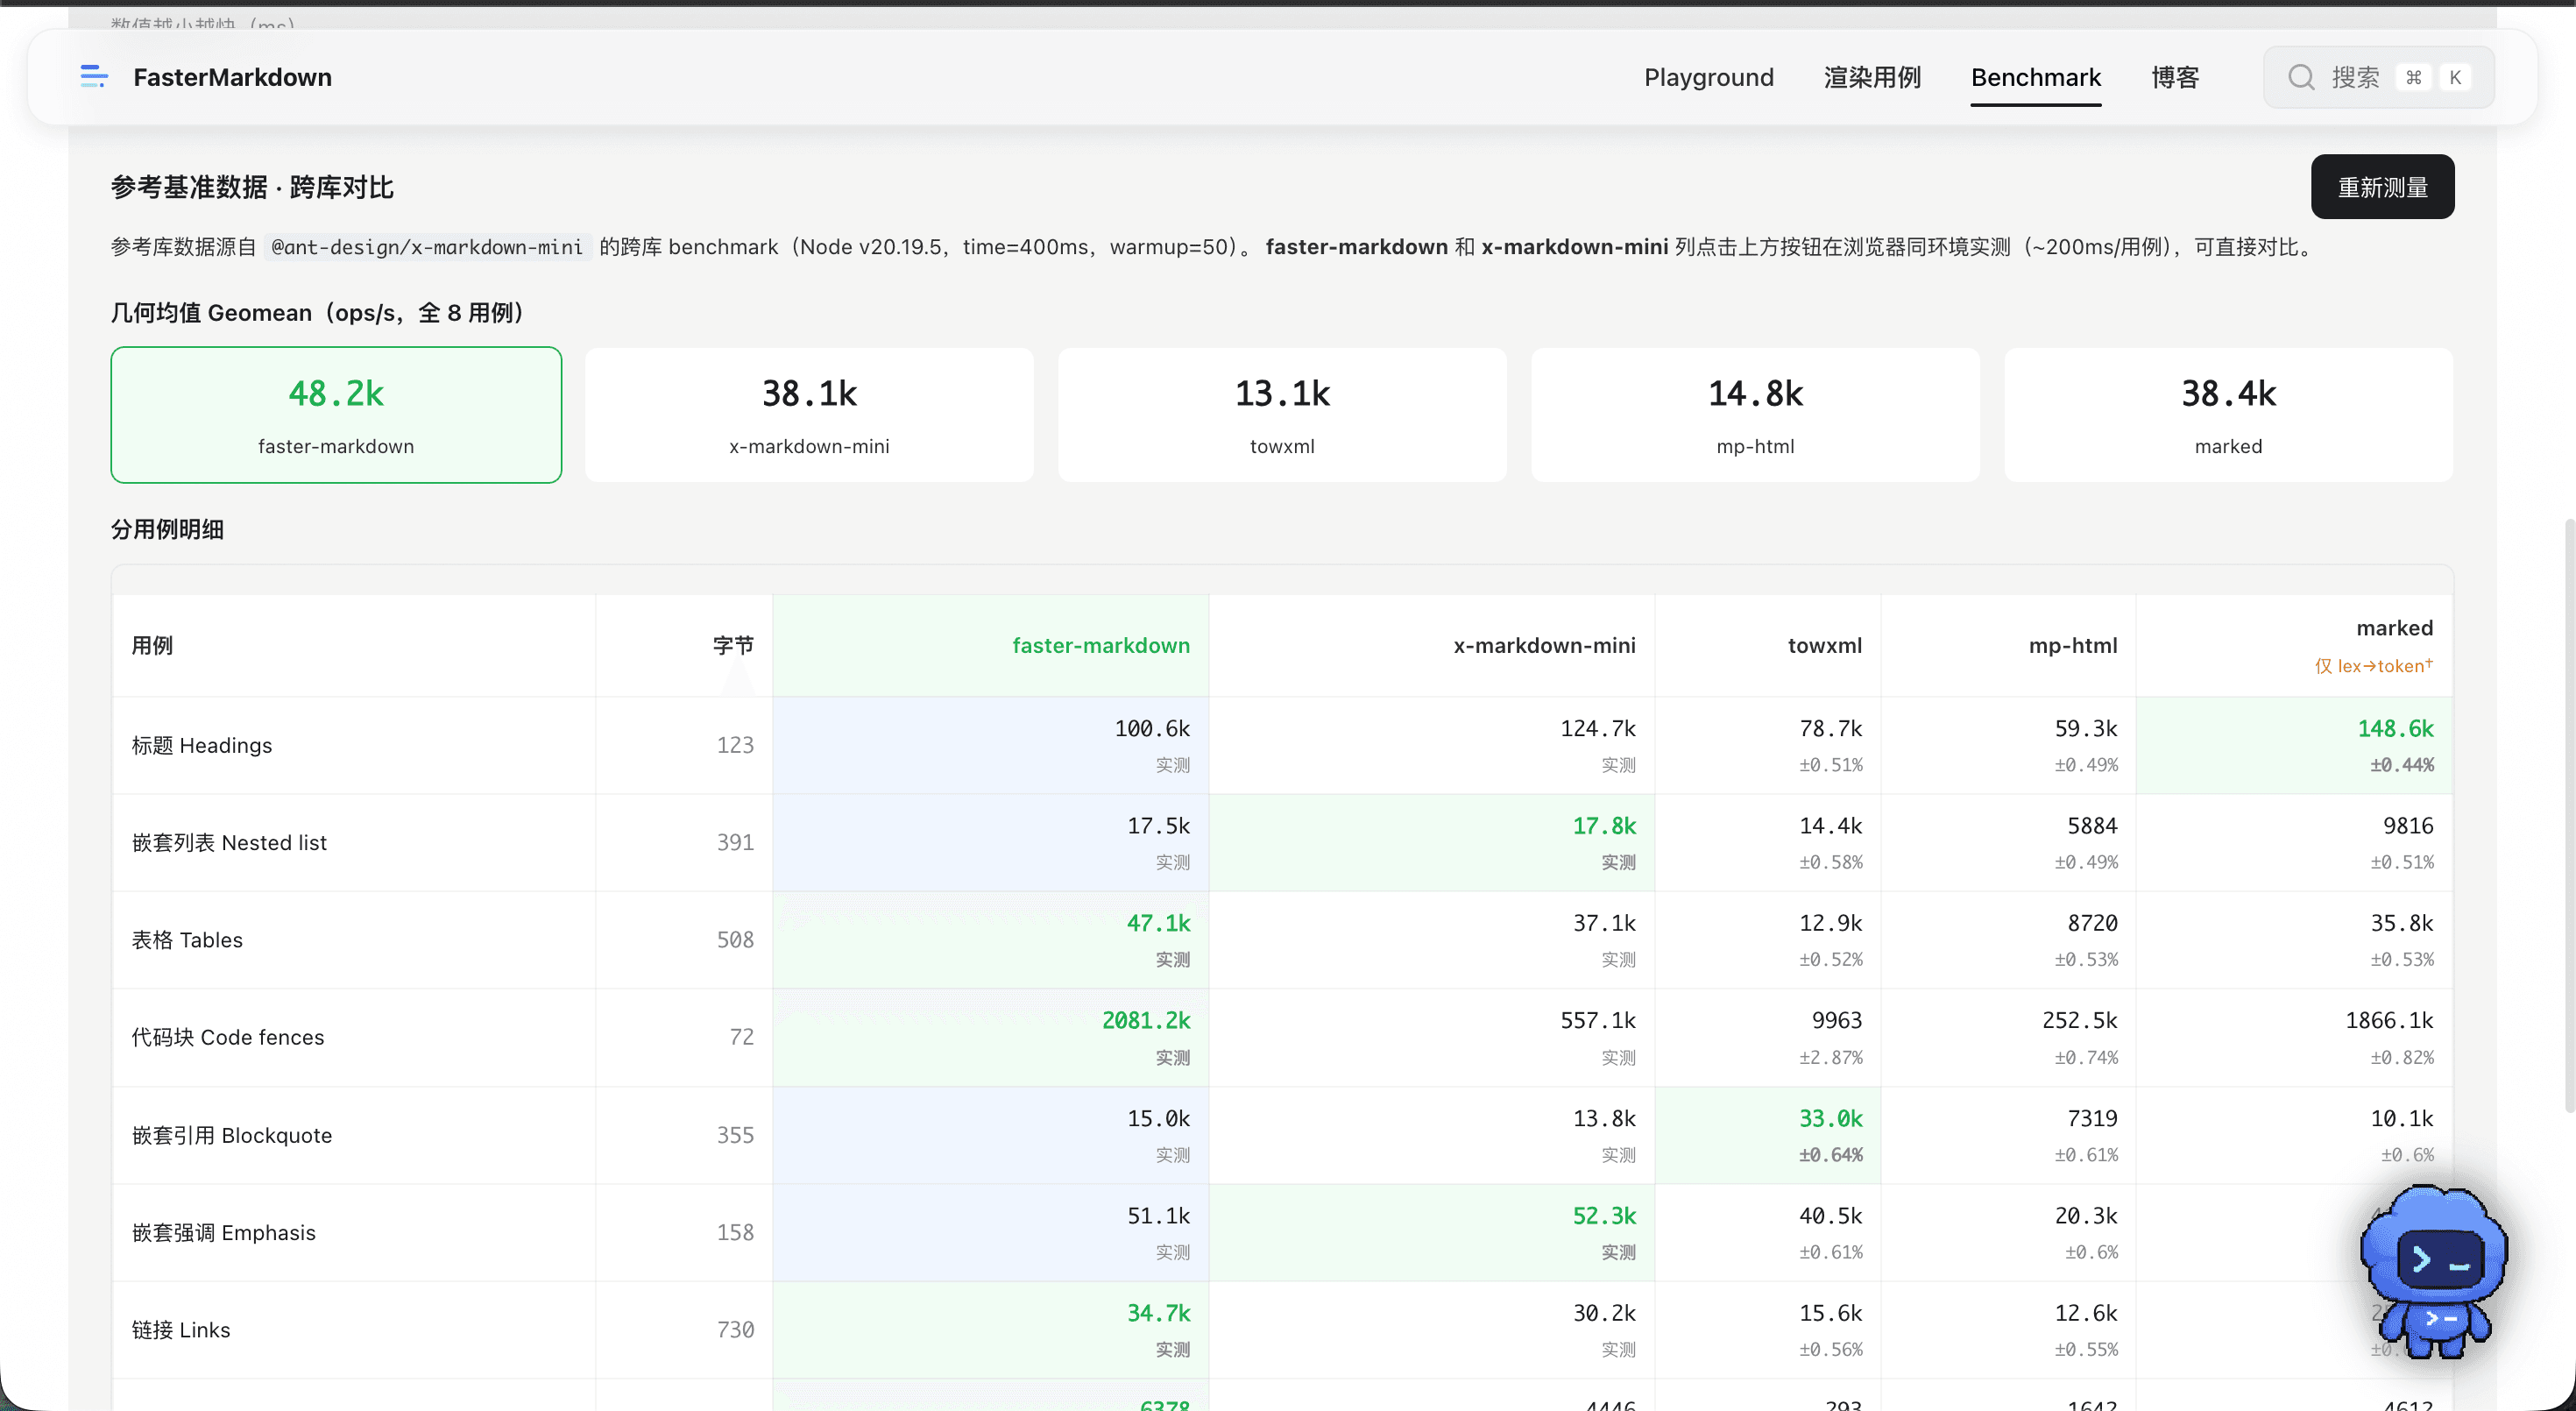
Benchmark 使用标题、嵌套列表、表格、代码围栏、引用、强调和链接等用例检查各条解析路径。由于不同库的输出范围并不完全一致,例如 marked 一列只统计 lexer 到 token 的过程,因此这组数据更适合作为同环境下的性能参考和版本回归基线,而不是脱离实现边界的绝对排名。
终帧对账与局部更新
流式阶段允许暂时的结构不确定:remend 给活跃尾部一个可展示版本,保守的提交边界避免历史块回跳。流结束后,才有完整文本用来确认 Setext 标题、复杂列表等语法。
这里不能简单 reset() 再全量渲染。那会丢掉节点缓存,整棵树重新挂载,并把已经出现过的内容当成新内容动画一次。faster-markdown 的终帧处理是一次对账:若最终文本仍是上一帧的前缀延续,就全量解析以修正最终结构,但保持版本与动画历史,不重新标记节点。结果是结构最终正确,视觉上也自然收尾。
前面已经让稳定块退出解析,到了视图层还可以再往前走一步:已经稳定的顶层 block 固定下来,后面不再反复传输。每一帧真正需要替换的,只剩活跃尾部和刚刚结算的少量区间。
[ 稳定块 ][ 稳定块 ][ 稳定块 ][ 活跃尾部 ]
      1          2          3         每帧更新
图中前两个稳定块不再出现在后续 setData 中;刚结算区间需要最后同步一次,之后也会进入稳定区。真正持续变化的,始终只有最后的活跃尾部。
这样做有两个直接收益。
第一,稳定内容不会随活跃尾部重绘。块级淡入动画不会因为后面多来了几个字而重新播放;活跃尾部中则可以去掉块级淡入,只保留更细粒度的逐字反馈。
第二,setData 可以只传变化范围,而不是完整树。渲染控制器除 nodes 外,再产出三个边界:
version:真正重建内容时变化;dirtyStart:本帧新增或修改节点的起点;settledStart:结构与动画都已结算的边界。
局部 patch 可以从 settledStart 开始:
const patch: Record<string, unknown> = { animation };
const rebuildFrom = Math.min(settledStart, prevLen);

for (let i = rebuildFrom; i < nodes.length; i++) {
  patch[`nodes[${i}]`] = nodes[i];
}

this.setData(patch);
从 settledStart 而非 dirtyStart 开始,是因为“刚结算”的节点可能刚完成动画 segment 的清除或合并,也需要最后同步一次。到这个阶段,稳定块/活跃尾部才真正闭环:历史 block 既不重新 parse,也不重新传到视图层。
例如上一帧已有 5 个顶层节点,本帧从 nodes[3] 开始产生新内容,但 nodes[2] 刚完成动画 segment 的合并,那么 dirtyStart 为 3,settledStart 为 2。本次 patch 需要从 nodes[2] 开始;下一帧 nodes[2] 进入稳定区后,更新范围才继续向后收缩。
动画对账
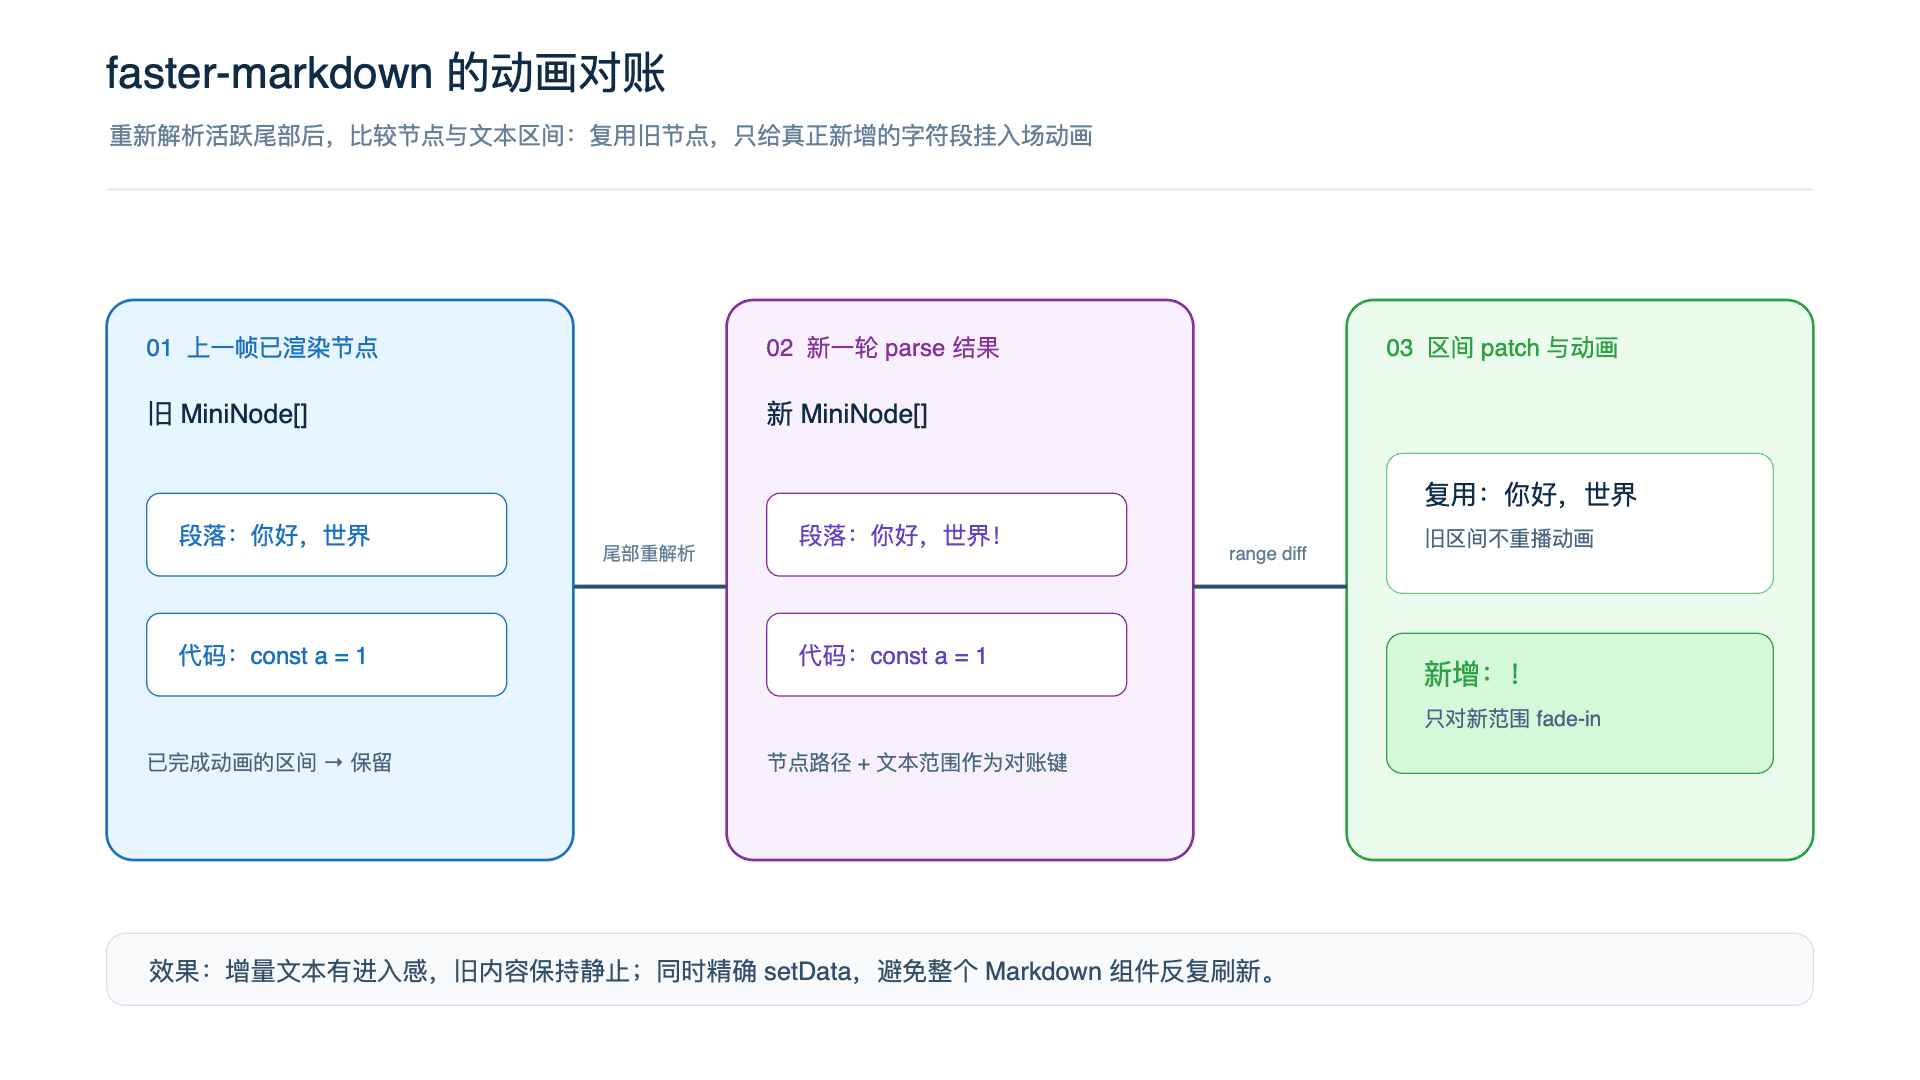
流式场景中,最常见的闪烁来源不是 CSS 本身,而是把“本帧重新构造的节点”误当成“刚出现的内容”。
比如上一帧是“今天北京”,下一帧追加为“今天天气很好”。如果整段文本重新淡入,旧字也会被重复播放。正确的判断应来自文本历史:按节点路径记录文本叶子的旧值和 animation segments,找出公共前缀,让它沿用原来的出生时间;只有新增后缀创建新 segment。
上一帧:今天北京
这一帧:今天北京天气很好
复用:  今天北京
新增:          天气很好
链接在闭合时可能从普通 text 变成 a 节点,这时可以尝试从相邻旧文本叶子继承 segment,避免“同一段字换了节点类型就重新出现”。
新增 segment 使用短暂的 fade-in 呈现。动画结束后,不应把 N 个 segment 在同一帧内合并成一个文本节点;wx:for 的子树从 N 项骤降为 1 项时,容易产生明显重排。更平滑的方式是渐进合并已经播放完的连续 segment,让结构逐步收敛到普通文本节点。
终帧结构修正仍沿用已有节点版本和动画历史,不重新标记已经展示过的文本。这样最终结构可以被校正,旧内容也不会重新播放动画。
4. 结语
在 Agent 对话中,流式 Markdown 的完整处理可以拆成三个职责清晰、前后衔接的阶段:SSE parser 恢复可靠的业务事件,StreamingRenderBuffer 调整文本进入页面的节奏,faster-markdown 负责增量解析、节点复用、局部更新和动画对账。
三层之间保持明确边界:数据接入层不决定展示频率,展示调度层不承担完整语法判断,Markdown 引擎也不重复处理已经稳定的历史内容。随着回答增长,解析、传输和动画成本仍然被限制在活跃尾部。
Last updated on